
对比 / JevModel
Valen 与 Jev 对比(2026):你的 Agent 该选哪种决策模型?
Valen(万澜)与 Jev 有什么关系,Agent 应该怎么选?对比视觉输入、开放权重、作者公布的推箱子评测、自行部署步骤及成本,区分演示成绩与实际生产表现。
最近更新:
速读:Valen 与 Jev 怎么选?
- 关系:Valen 是受 Jev 启发的独立多模态模型,并非官方 Jev 版本。
- 选 Jev:需要基于文字的类型化判断,并希望通过托管接口减少模型运维工作。
- 考虑 Valen:决策需要图片或视频证据,且你能运行并评估它的开放权重。
- 评测边界:Preview 在筛选过的 500 条推箱子单步样本上报告 87.60%,无法据此判断它优于 Jev。
关系来自决策接口,模型本身是独立项目
Valen 自己的 README 将它描述为受 Jev 启发、加入视觉输入的结构化决策模型。TypeSafe 的 Jev 针对状态和问题返回类型化答案;Valen 将类似接口用于文字、图片和视频。它使用 Qwen3.5 骨干与自己训练的决策头,把它称为官方 Jev 视觉版会误导读者。对 Agent 开发者,值得判断的是:下一步动作是否需要像素证据,以及是否值得单独运行一个模型。本文是独立资料分析;JevModel 与两个项目均无关联,本站当前工作台也没有提供 Valen。
自主 Agent 的结构化决策模型指南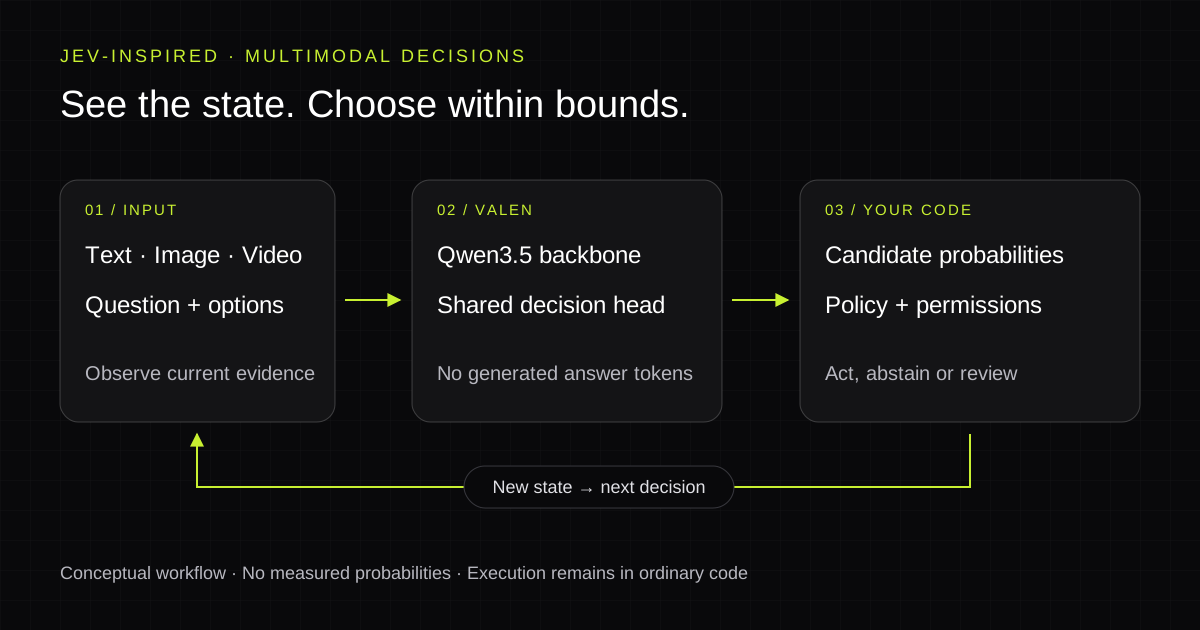
状态包含像素时,改变了什么?
截图可能包含文字记录遗漏的证据:按钮是否禁用、障碍物在哪里、目标物是否可见。Valen 根据这些证据和问题指令给候选项打分。Qwen 实现通过共享决策头读取隐藏状态,不生成答案 token;但参考实现仍逐分支执行骨干计算:Choice、Noul 每题一个分支,Score 每个等级一个分支。因此,一道三级 Score 加一道 Choice、一道 Noul,需要五次骨干前向计算。类型化输出限定了答案空间,却不能修正错误观察或不完整的候选列表。
按实际需求对比
下表比较已记录的接口与运行方式,不是准确率排名。问题结构像 Jev,并不代表 SDK、媒体预处理或响应完全兼容;应先对照真实端点或本地实现检查,再决定能否复用接入代码。
| 决策因素 | 托管 Jev / 本站 | Valen |
|---|---|---|
| 项目关系 | Jev 是 TypeSafe 的模型;本站提供独立服务。 | 受 Jev 决策接口启发的独立实现。 |
| 输入证据 | 本站工作台接收文本 / JSON 状态,不接收媒体上传。 | 项目支持文字、图片与视频。 |
| 答案类型 | 通过已记录的 API 使用 Choice、Score、Noul。 | 通过项目决策接口使用 Choice、Noul、Score。 |
| 运行责任 | 托管模型调用;请求数据发送给服务提供方。 | 下载匹配的 checkpoint 与骨干权重,自行负责推理和维护。 |
| 选型证据 | 用实际托管模型和工作流评测自己的任务。 | 公开 Preview 针对推箱子训练,应另测自己的视觉领域。 |
看一次判断怎样变成动作
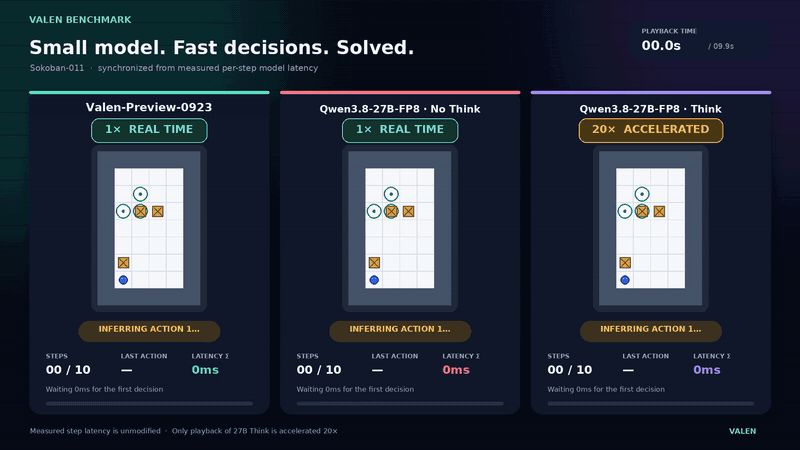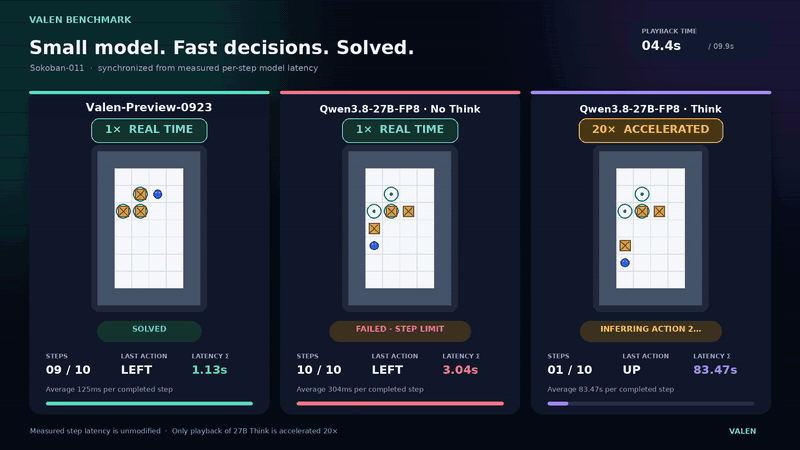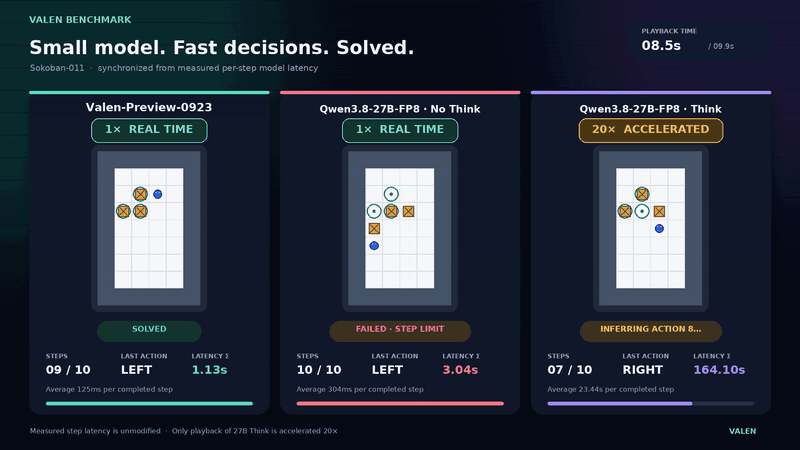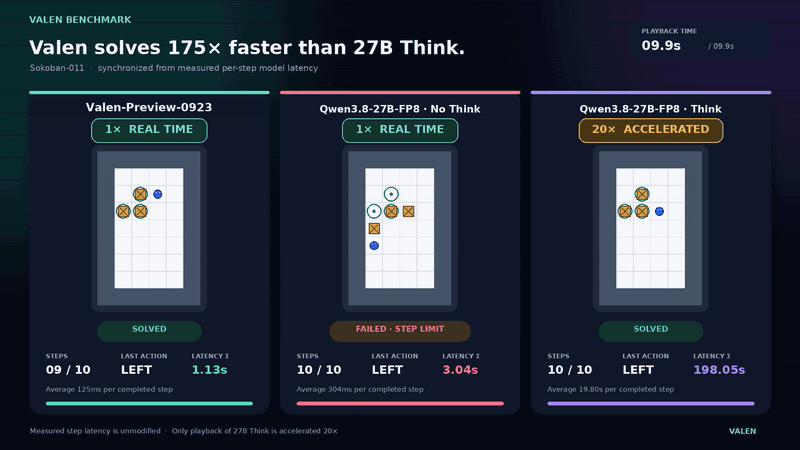
项目的推箱子回放展示了一种实用流程:观察棋盘、选择方向、执行移动,再观察新棋盘。作者报告该展示关卡用了九次判断,累计决策延迟为 1.13 秒。这是选取的演示,不是与托管 Jev 的实测速度对比,也不保证浏览器自动化有同样表现。展开下方动画即可查看,收起后隐藏动态内容;来源注明思考模型的回放经过加速,不能凭播放画面直接比较耗时。
展开 / 收起项目演示动画
按真实范围理解 Preview 分数
Preview 模型卡报告:500 道推箱子单步题准确率为 87.60%,在每局最多 200 步的条件下,100 局完成了 38 局。两项指标分别测一次动作选择和整段流程完成,不能混用。模型卡还披露,这 100 个简单关卡先保留了 2B RLCD 模型成功的案例,再补齐集合,评测因此受到模型结果筛选影响,并非无偏的完整基准。系列总览图中的 General 视觉问答结果使用另外训练的 checkpoint,不是该推箱子 Preview 的成绩。这些数据也不提供 Valen 对 Jev 的直接比较。用于生产选型的测试集,应独立于两个模型的成功案例来选取。
置信度是需要验证的信号
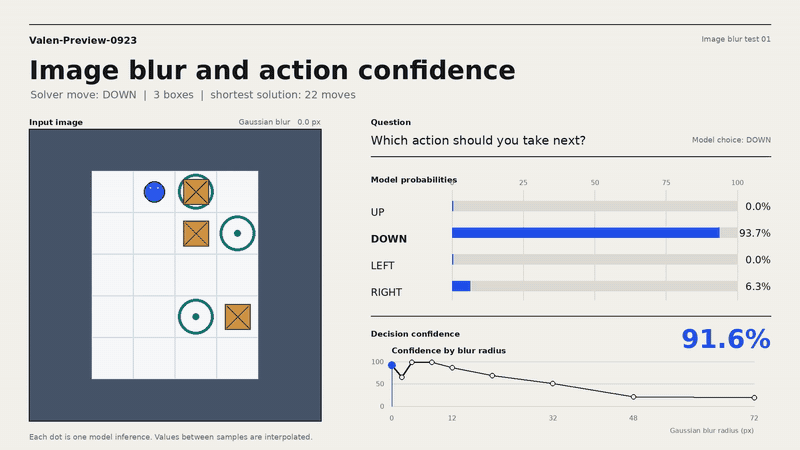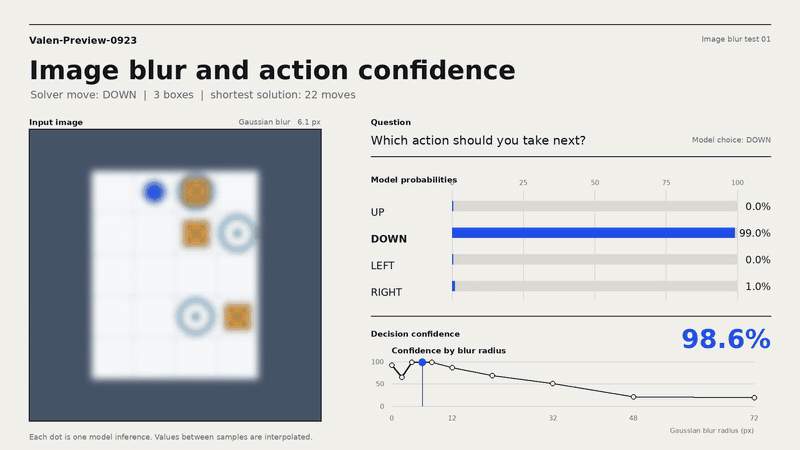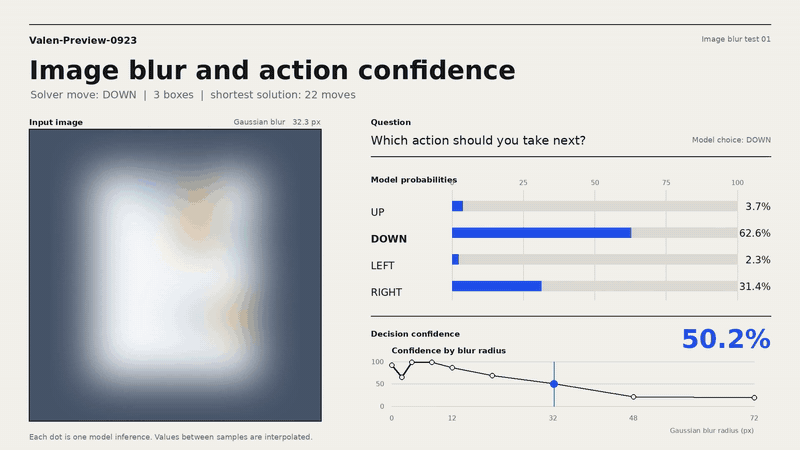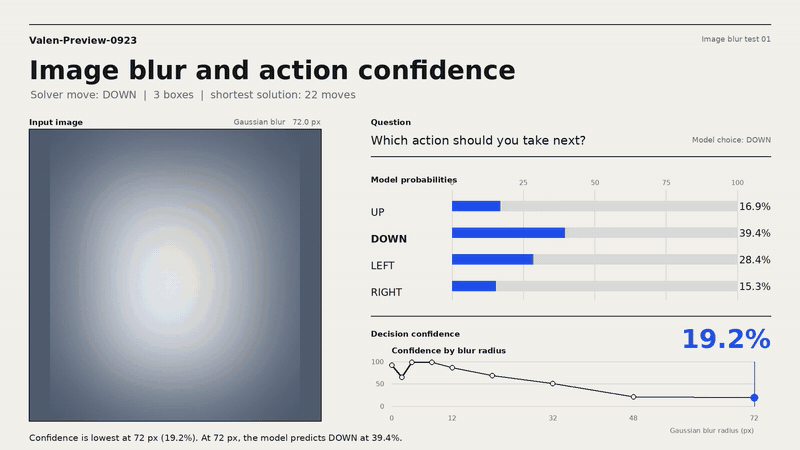
Valen 评估文档把 confidence 定义为概率分布的集中程度。Choice 将最大概率相对于均匀分布基线缩放;Noul 只返回 true 的概率,没有单独的 confidence 字段。模糊演示展示了视觉信息变差时分布集中度的变化,却不能证明其他任务上的正确概率已经校准。设置执行阈值前,应在独立样本上检查可靠性。适当加入 unknown 或人工复核候选,并让代码始终执行权限检查,即使置信度很高。
展开 / 收起模糊实验动画
可以怎样试验截图工作流?
设想一个内部工具,将失败任务的截图分流到 retry、inspect_logs 或 human_review。提供裁剪后的截图,并准确描述允许的动作;重试预算、访问校验和最终执行保留在普通代码中。截图不完整或错误类型陌生时,应能进入复核。先采用影子模式:操作员照常选择动作,模型结果只记录下来用于对比。工程负责人复查错误和交接,安全负责人决定哪些截图可以进入流程。这是建议的评估场景,不是已发生的 Valen 部署案例,也不保证推箱子 Preview 能理解你的软件界面。
自行部署:安装前先检查条件
项目参考环境要求 Linux、Python 3.10+ 与 NVIDIA GPU。Preview 是 checkpoint 加配置文件,不是可单独加载的 AutoModel 仓库:它需要匹配的 Qwen3.5-2B 骨干,并保留训练时的 vision_top stage。应按模型卡使用 prepare_model 脚本核验基础模型版本,而不是任意混搭下载。下方是已记录的配置命令;本文没有执行它们或下载模型权重。另一个 vLLM Jev 项目列出 Linux、Apple Silicon 上的 Valen 服务支持,包括实验性短视频输入;那是需要另外验收的运行时,有独立的安装和请求规则。
git clone https://github.com/Liuziyu77/Valen.git Valen
cd Valen
bash scripts/setup/bootstrap.sh
source .venv/bin/activate
hf download Valen-Team/Valen-Preview-0923 --local-dir models/Valen-Preview-0923
python scripts/setup/prepare_model.py
python -m valen.inference \
  --checkpoint models/Valen-Preview-0923 \
  --data data/smoke/train.jsonl \
  --output predictions.jsonl
成本与许可也是选型条件
Valen 仓库代码以 Apache 2.0 发布,Preview 模型卡也标注 Apache 2.0;基础模型和来源数据集仍适用各自条款,重新分发或商业训练前应检查完整依赖链。开放权重减少了对托管模型的依赖,但 GPU 运行与闲置、媒体预处理、升级和复核仍由运营方承担。应比较每次成功完成工作流的成本,把错误动作和人工复核也算进去,而不只比较 token 单价。只有媒体、日志和监控链路都按本地方式配置,自托管推理才能保持数据在本地;下载开放权重本身不构成隐私保证。
用独立测试做最后判断
如果文本或 JSON 已经包含窄范围判断所需的证据,可以先评测托管 Jev 路径。若原始像素不可缺少,团队也能负责部署或任务专用训练,Valen 值得进入受控试验。调参前固定有代表性的样本,加入模糊输入、证据缺失、误导性选项名和没有合适动作的案例;校准集与测试集分开。记录错误动作率、复核率、端到端 p50/p95 延迟和完整流程成功率,并指定负责人在 checkpoint 或预处理改变后检查回归。最终判断应落在应用能接受哪些错误和运营责任,而不是哪段选取回放看起来最快。
JevModel 为独立项目,与 TypeSafe AI 无关联。